背景
科大讯飞的星火系列大模型从 2023 年的 V1.0 起步,此后经历多轮迭代:V3.0 主打中文语言能力,V4.0 则被公司拿来与 GPT-4 Turbo 在整体表现上做比较[2]。这条产品线的每一步升级背后都绕不开同一个问题——训练所用的算力从哪里来,以及能否持续稳定地供给。
发布
2026 年 2 月 11 日,科大讯飞通过官方微博账号宣布发布讯飞星火 X2[1]。公司把这次发布描述为通用能力的全面升级[1],并强调 X2 是在全国产算力上训练完成的[1]。
所谓「全国产算力」,指的是训练过程中使用的芯片、服务器和计算平台均来自国内厂商,而不是依赖进口的加速卡。对一个模型研发方来说,这件事关乎供给:训练大模型需要在很长时间里占用大量加速卡,算力底座放在国内,意味着这项工作不必依赖海外的硬件供应。
主打的场景
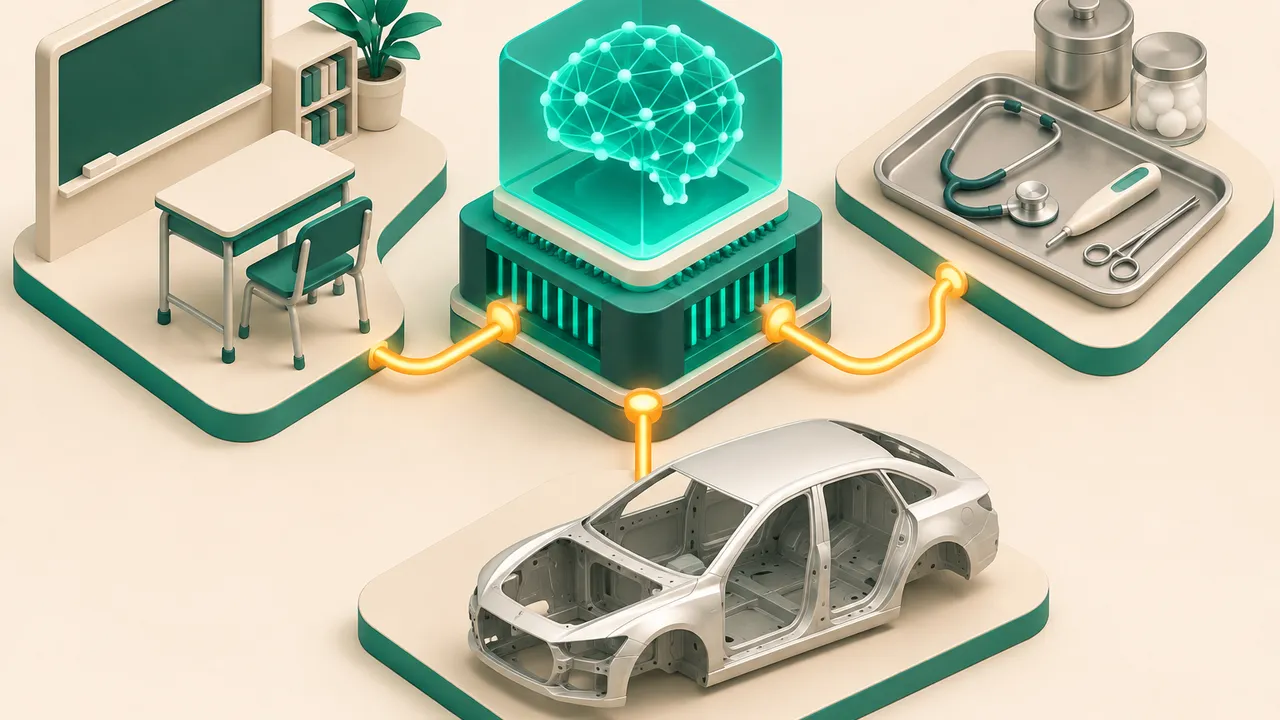
星火 X2 面向教育、医疗、汽车和智能体(agent)场景[1]。智能体在这里指的是能够调用工具、分多步完成一项任务,而不只是回答单个问题的模型应用形态。
医疗是描述最具体的一块。科大讯飞表示,X2 针对诊断准确率与治疗推荐做了调优,并强化了对复杂病历的解析能力[2]。病历大多是非结构化文本——医生的记录、检查结果、既往史,格式并不统一——能不能读懂这类材料,与回答一个通用问题是两回事,很依赖针对具体领域的调优。
市场位置
对这次发布的报道提到,科大讯飞在 2025 年的大模型招标中中标情况排名第一,金额为 23.16 亿元[2]。招标是政府机构、医院、学校、企业等采购方公开发布需求、由供应方竞标、再从中选定合作方的过程,因此这个数字反映的是当年该公司签下的大模型相关工作量,而不是模型本身的能力高低。
意义
星火 X2 处在中国大模型领域的两个趋势交汇处。其一,重心从通用能力榜单转向具体行业场景,什么样的表现算好,由客户的任务来定义,比如能否正确读懂一份病历,而不是由一套通用测试来定义。其二,是算力底座:公开宣布模型完全在国内算力上训练完成,等于把供应链本身写进了产品说明,而不只是当作一项工程细节[1]。
放在前几代产品的脉络里看,公司的叙述是延续而非断裂:2023 年的 V1.0、面向中文的 V3.0、与 GPT-4 Turbo 相比的 V4.0,再到如今的 X2,被描述为在国产算力底座上的一次全面升级[1][2]。因此这次发布既是在说模型,也是在说公司打算长期使用的训练基础设施。
来源
- 1
- 2
引用本页: 科大讯飞发布讯飞星火 X2. TellWorld, https://www.tellworld.net/zh/news/spark-x2-2026. 更新于 2026-11-08