1988 年
《ALVINN:神经网络中的自主陆地车辆》
ALVINN 是一个三层反向传播网络,以摄像头与激光测距仪的图像为输入、输出车辆应行驶的方向,用模拟道路图像训练,并在卡内基梅隆大学的自主导航测试车上做了验证。
约翰·麦卡锡获 1988 年京都奖
1988 年,京都奖「先进技术」部门把奖项授予约翰·麦卡锡,表彰他对人工智能领域的根本性贡献以及发明编程语言 LISP。
《用时序差分方法学习预测》
理查德·萨顿1988年的论文提出时序差分学习:用相邻两次预测之差分配信用的增量式预测方法,比传统方法更省内存、预测更准。
1989 年
Backpropagation Applied to Handwritten Zip Code Recognition(反向传播用于手写邮政编码识别)
1989年,杨立昆与同事在AT&T贝尔实验室用反向传播训练卷积网络,识别美国邮件上手写的邮政编码数字,测试错误率为5.0%。这项工作表明,卷积结构可以在真实任务中端到端地学习。
1990 年
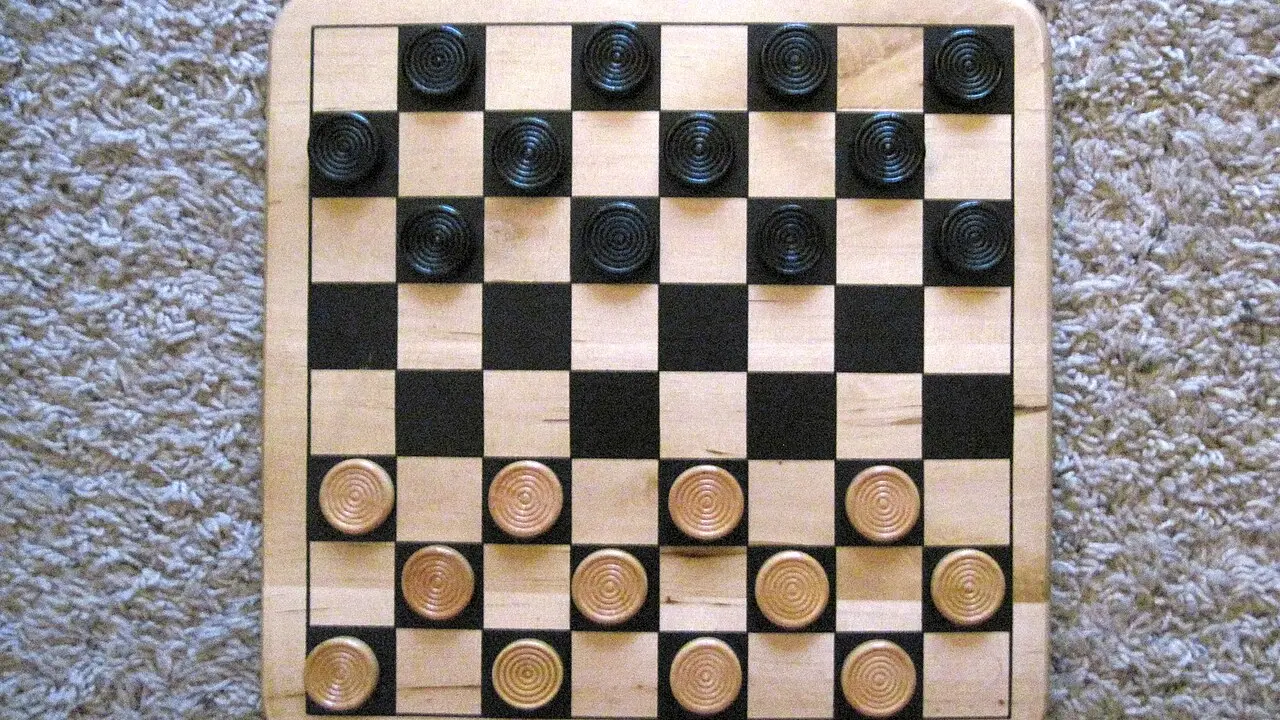
Chinook 首次获得人类世界冠军挑战权
1990 年,Chinook 成为首个在任何游戏中获得挑战人类世界冠军资格的程序,开启了它参加人类冠军赛并最终求解西洋跳棋的历程。
休·勒布纳设立勒布纳奖
1990年,纽约慈善家休·勒布纳出资10万美元,奖励首台通过受限版图灵测试的机器,勒布纳奖比赛由此设立。
大象不下棋
Rodney Brooks 在 1990 年的这篇论文中主张从底层出发造人工智能:把与环境持续进行的物理互动当作设计智能系统的主要约束,而不是沿用此前约三十年主导领域的抽象符号操作。
1991 年
首届勒布纳奖竞赛举办
1991年11月8日,首届勒布纳奖竞赛在计算机博物馆举行,Joseph Weintraub 的 PC Therapist 让10位评判中的5位以为它是人,赢得1500美元奖金和一枚铜牌。
1992 年
Q 学习
这是一篇 1992 年由 Watkins 与 Dayan 发表的技术札记,提出了 Q 学习:一种计算量小、增量式的学习最优动作价值的方法,并证明它在特定条件下以概率 1 收敛到最优值。
IBM 开发 TD-Gammon
TD-Gammon 是 IBM 的 Gerald Tesauro 开发的双陆棋程序,用时间差分学习让神经网络通过自我对弈学会评估局面,棋力接近当时顶尖人类棋手,是强化学习早期的重要成果。
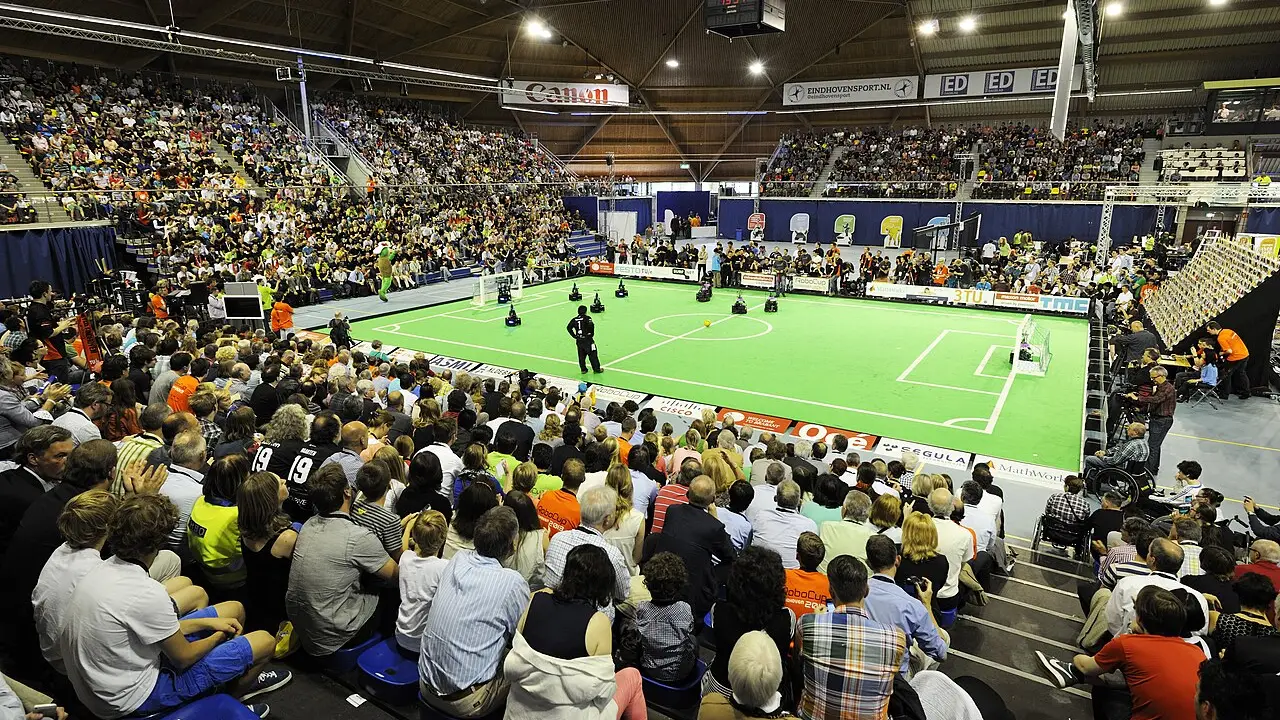
机器人足球被提出作为 AI 重大挑战
1992 年,Mackworth 的论文与东京的 AI 重大挑战研讨会各自独立提出了让机器人踢足球的设想,希望以足球推动人工智能与机器人研究。
《时序差分学习的实践问题》(TD-Gammon)
Gerald Tesauro 1992 年的论文以自对弈西洋双陆棋为案例,检验时序差分学习能否解决复杂现实任务。
最优间隔分类器训练算法
这篇 1992 年的论文由 Boser、Guyon 和 Vapnik 提出一种训练算法,最大化训练样本与决策边界之间的间隔,并在光学字符识别实验中检验其泛化表现。[^1]