背景
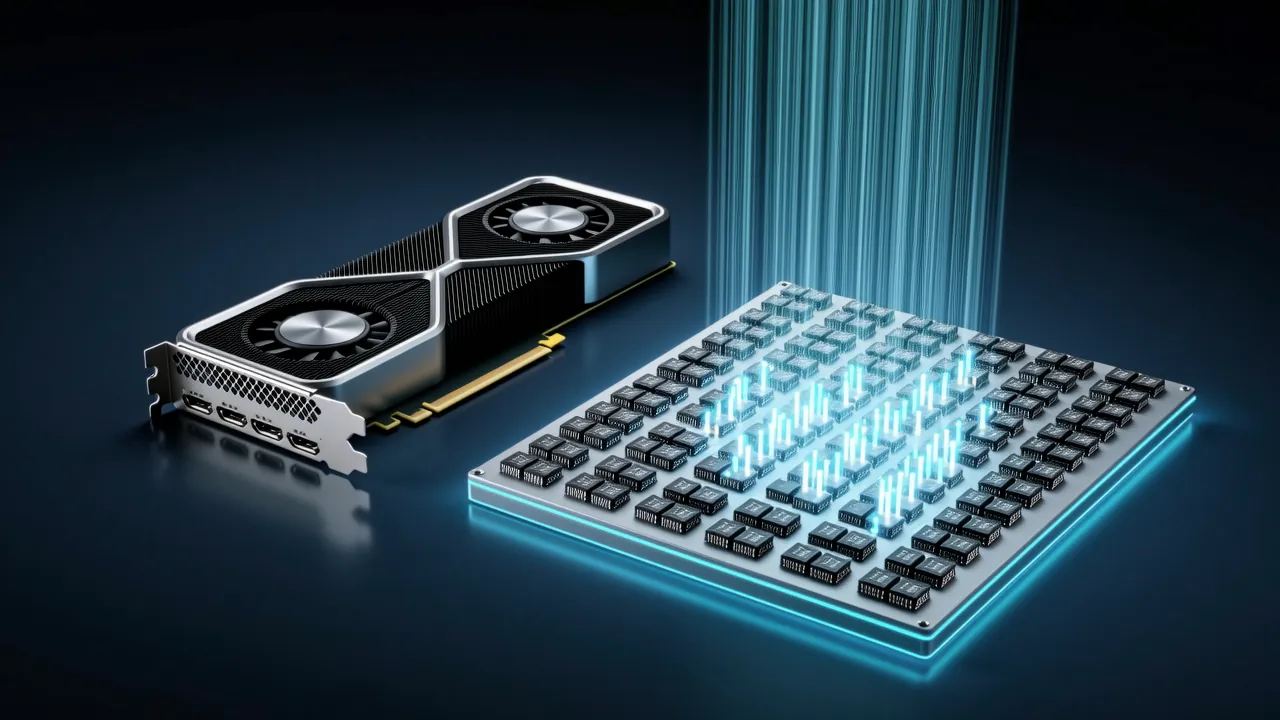
图形处理器天生适合「同一件小事重复做很多遍」:一帧画面由大量像素组成,每个像素都要经过相似的计算。这种设计让芯片上排满算术单元,但长期以来这些单元只能通过图形接口使用,程序员若想拿 GPU 做别的事,就得把计算伪装成绘图。CUDA 改变的就是这一点——它把芯片上的并行核心直接开放给普通程序。
发布
2006 年 11 月 8 日,NVIDIA 发布 CUDA,称其是一种新的计算架构,让程序员可以使用 GPU 上数百个片上处理器核心做通用计算,而不只限于图形处理[2]。与之配套的是面向 GPU 的 C 编译器开发环境,NVIDIA 称此为业界首创[2]。发布时,软件开发者套件向已注册的开发者和研究人员开放,NVIDIA 声称对于适合的问题,相比传统做法可获得最高 100 倍的加速[2]。最早运行 CUDA 的硬件是 GeForce 8800 显卡[2]。
2007 年发布 1.0
NVIDIA 的工具包存档把 CUDA Toolkit 1.0 记为 2007 年 6 月发布,随后在 2007 年 12 月发布 1.1 版[1]。带版本号的工具包,是此前那次发布的落地形式:一套可下载的编译器与程序库,让研究者不必事事绕道图形管线就能编写 GPU 代码。
执行模型
在 CUDA 模型中,成千上万个被称为线程(thread)的轻量程序并行运行,并且可以协作解决同一个问题[2]。分工是刻意安排的:GPU 承担细粒度、数据密集的工作,CPU 负责控制与数据管理[2]。什么样的任务适合这种安排?如果一件事能拆成许多彼此相似、各自独立的小块——比如对一张大图的每个像素做同样的处理——这些小块就能同时分给大量线程;反过来,必须一步步顺序推进、后一步依赖前一步结果的逻辑,仍留给 CPU。
为什么重要
NVIDIA 的公司大事记把 CUDA 描述为把 GPU 的并行处理能力开放给科学与研究的那一步[3]。它的意义在于改变了使用门槛:一块原本为渲染而生的芯片成了通用的并行处理器,研究者可以用熟悉的语言为它编程,而工具包向所有注册者提供,不再被锁在图形工作里。
从图形到深度学习
CUDA 后来成为 GPU 深度学习的底层[1]。2012 年的 AlexNet 用手工优化的 GPU 卷积实现、在 GTX 580 显卡上完成训练[1]。2014 年 NVIDIA 发布 cuDNN,这是 CUDA 之上的一套优化深度学习例程库,在一个标准模型上把 Caffe 框架加速了 36%[1]。今天 NVIDIA 把 CUDA 描述为其加速计算(accelerated computing)平台,即让应用程序使用 GPU 的那层软件:程序员可以通过 C++、Python、Fortran 等语言使用它,也可以通过 PyTorch 这类库和框架使用它[4]。
来源
- 1CUDA Toolkit ArchiveNVIDIA Developer
- 2NVIDIA Unveils CUDADigital Engineering 24/7
- 3
- 4CUDANVIDIA Developer
引用本页: NVIDIA 发布 CUDA 1.0. TellWorld, https://www.tellworld.net/zh/news/cuda-2007. 更新于 2026-11-08