背景
图像分类就是让机器判断一张图片属于哪一类,它长期被当作检验神经网络的基准任务,而 ImageNet 竞赛(ILSVRC)则是大规模系统同场比较的场合。让这类系统更强的一个自然办法是加深网络:层数越多,理论上能够表达的函数就越复杂。但深度并不好用——层一多,训练就更困难,单纯堆叠层数未必换来更准的分类结果。2015 年的这场竞赛,实际上就是在问这个天花板能不能被抬高。
发生了什么
2015 年 12 月 10 日,论文《Deep Residual Learning for Image Recognition》首次提交到 arXiv [1]。摘要写明:残差网络(residual net)的集成在 ImageNet 测试集上取得 3.57% 的错误率,赢得 ILSVRC 2015 分类任务第一名 [1]。维基百科关于 ImageNet 的条目从另一个角度给出了同一个数字:微软那套超过 100 层的极深卷积神经网络以 3.57% 的测试集错误率赢下 2015 年的竞赛 [2];同一处还写道,2015 年的获胜方案是 ResNet,并且超过了人类表现 [2]。也就是说,拿下第一名的不是既有设计再加深一点的版本,而是一套按不同原理搭起来的网络。
深度与残差
论文评估的残差网络最深达到 152 层,摘要说这比 VGG 网络深 8 倍,而复杂度更低 [1]。这样的深度是结果外在可见的标志;真正让它训练得起来的,是「一层到底要学什么」这一处改动。
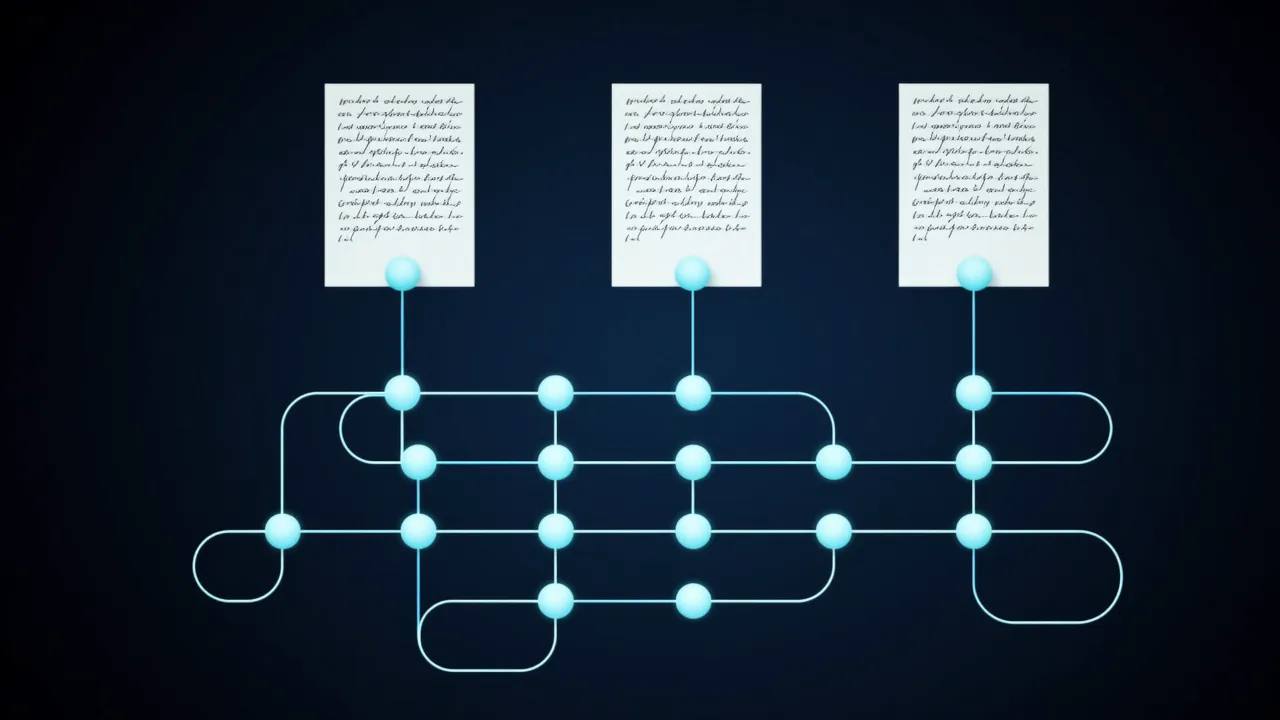
常规做法是让一叠层直接学习从输入到输出的映射,论文称之为学习无参照的函数(unreferenced function);它把这改成让层学习相对于该层输入的残差函数(residual function)[1]。通俗地说,一组层不再需要从零造出想要的输出,只需要造出「想要的输出」与「进来的东西」之间的差,而输入本身会原样传到后面加回去。如果这组层最好的做法是什么都不改,那么残差的目标就是 0——这是一个很容易命中的目标;反过来,硬要一叠非线性变换精确复现自己的输入,则困难得多。于是「什么都不做」和「只做一点小改动」都变得廉价,网络可以叠得很深,而不至于让新加的层把前面已经学到的东西破坏掉。
为什么重要
两个数字说明了分量。一是深度:152 层,比 VGG 深 8 倍而复杂度更低 [1]。二是精度:测试集 3.57% 的错误率、分类任务第一名 [1],按维基百科的说法还超过了人类表现 [2]。两者合起来,动摇了「极深的网络不值得训练」这一实际判断——这里的深度不是靠成比例地抬高复杂度换来的,也没有以牺牲准确率为代价。
在发展中的位置
残差的写法不依赖某个数据集或某场竞赛,它讲的是如何参数化一叠层,凡是会用到这种层叠的地方都可以套用。2015 年的这个结果公开确立的一点是:可用的深度上限并不在原先以为的位置;而论文给出的说法——学残差,而不是学整个映射——也提供了一种简洁的方式来描述这件事为何成立。就公开记录而言,这篇论文在 arXiv 上的提交日期是 2015 年 12 月 10 日 [1],它报告的成绩是 ILSVRC 2015 分类任务第一名、ImageNet 测试集错误率 3.57%,所用残差网络最深 152 层 [1];维基百科也把这一获胜方案记为超过了人类表现 [2]。
来源
- 1
- 2ImageNetWikipedia
引用本页: ResNet 以 3.57% 错误率赢得 ILSVRC 2015. TellWorld, https://www.tellworld.net/zh/news/ilsvrc-2015. 更新于 2026-11-08