这篇适合谁,读完能做什么
这篇适合刚接触 AI 智能体、想先弄清楚它到底是什么的读者。读完后,你应该能用一句话说明智能体的定义,分清它的「大脑」和「身体」,并理解思考、行动、观察这个循环是怎样运转的。
智能体是什么
智能体是一个系统:它借助 AI 模型与环境交互,以完成用户设定的目标。它结合了推理、规划和行动的执行,行动往往要通过外部工具来完成[1]。
可以用一个管家的例子来理解。假设你对智能体说:「请给我来杯咖啡。」它先理解这句自然语言,然后推理和规划步骤:去厨房、使用咖啡机、冲泡咖啡、把咖啡端回来。接着它调用手边的工具,比如咖啡机,完成任务。智能体之所以叫「智能体」,是因为它有能动性(agency),也就是能与环境互动[1]。
大脑和身体
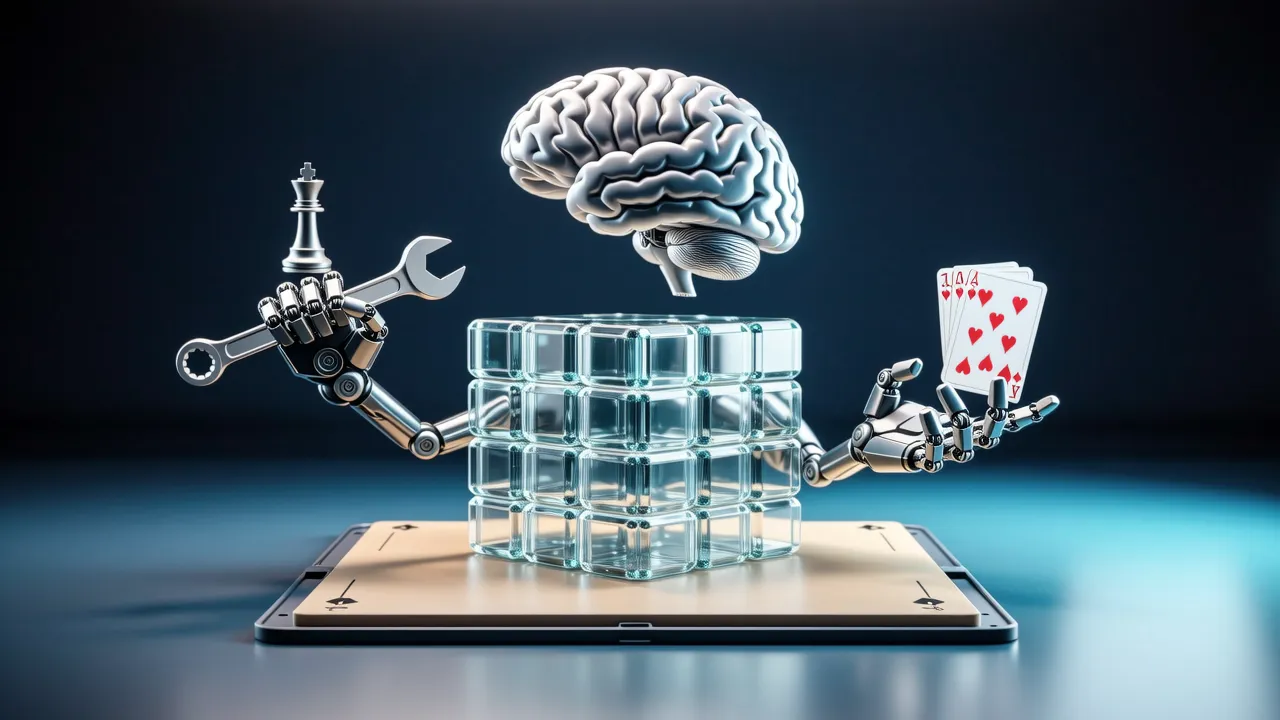
智能体可以拆成两部分[1]:
- 大脑是 AI 模型,负责推理和规划,并根据当前情况决定采取什么行动。
- 身体是智能体被赋予的能力和工具,决定它能做的动作范围。比如人类没有翅膀,就不能「飞」,但可以走、跑、跳、抓取。
同一个大脑,配上不同的工具,能做的事情就完全不同。
智能体的能动性有几个层级
智能体的能动性是一个连续的光谱,从低到高大致分为五级[1]:
- 简单处理器:输出不影响程序的流程。
- 路由器:输出决定基本的控制流,比如走哪条分支。
- 工具调用者:输出决定要执行哪个函数,常见写法是
run_function(llm_chosen_tool, llm_chosen_args)。 - 多步智能体:输出控制迭代和是否继续,常见写法是
while llm_should_continue(): execute_next_step()。 - 多智能体:一个智能体工作流可以启动另一个智能体工作流。
越往上,模型对程序流程的控制就越大,同时也越难预测和测试。
大模型为什么需要工具
智能体的大脑最常见的是大语言模型(LLM),它输入文本,输出文本。GPT-4、Llama 和 Gemini 都是这类模型的例子[1]。另有一类视觉语言模型(VLM),它与大语言模型相似,但还能理解图片作为输入[1]。
大语言模型本身只能生成文字。但 HuggingChat、ChatGPT 这类应用能生成图片,是因为开发者为模型加了工具,模型可以调用这些工具来生成图片[1]。
所以,智能体能做的任何事,原则上都是通过工具实现的。一个动作(action)可能要用到多个工具才能完成,动作和工具并不是同一个概念[1]。工具的设计对智能体的质量影响很大:有些任务需要专门设计的工具,有些则可以用 web_search 这类通用工具解决[1]。
工具怎么写,大模型怎么调用
工具本质上就是一个普通的 Python 函数,带有说明文字(docstring)。比如一个发邮件的工具可以这样定义[1]:
def send_message_to(recipient, message):
    """Useful to send an e-mail message to a recipient"""
...大模型需要用它时,会生成运行这个工具的代码。例如[1]:
send_message_to("Manager", "Can we postpone today's meeting?")这就是「个人助理」类智能体的工作方式:先理解指令,再决定调用哪个工具。
思考:智能体的内部推理
思考(Thought)是智能体的内部推理和规划。它利用大语言模型分析提示词里的信息,相当于智能体解决问题时的内心独白[2]。
思考让智能体能评估当前观察到的情况,决定下一步行动,把复杂问题拆成更小的步骤,并随着新信息调整计划[2]。常见的思考类型包括:规划、分析、决策、解决问题、整合记忆、自我反思、设定目标和排序优先级[2]。
思维链(CoT)和 ReAct 有什么不同
思维链(Chain-of-Thought,CoT)是一种提示技巧,引导模型在给出最终答案之前一步一步地思考,通常以「Let's think step by step.」开头。它适合逻辑和数学题,过程中不调用外部工具[2]。下面是一个 CoT 的例子:
Question: What is 15% of 200?
Thought: Let's think step by step. 10% of 200 is 20, and 5% of 200 is 10, so 15% is 30.
Answer: 30
ReAct 则是把推理(Reasoning)和行动(Acting)结合起来的方法。它在思考、行动、观察之间交替进行:思考是内部推理,行动是使用工具,观察是接收工具返回的结果。这让智能体能解决需要多步完成的复杂任务[2]。一个 ReAct 的例子如下:
Thought: I need to find the latest weather in Paris.
Action: Search["weather in Paris"]
Observation: It's 18°C and cloudy.
Thought: Now that I know the weather...
Action: Finish["It's 18°C and cloudy in Paris."]
两者的区别在于,CoT 不使用外部工具,ReAct 通过行动和观察与外部世界交互。CoT 适合逻辑、数学和纯内部的任务,ReAct 适合信息检索和动态的多步任务[2]。
另外,DeepSeek R1 和 OpenAI 的 o1 这类模型经过微调,学会在回答前先思考,它们用 <think> 和 </think> 标记把推理阶段与最终答案分开。与 ReAct、CoT 这类提示策略不同,这是一种训练层面的技术[2]。
智能体的常见例子
- 个人虚拟助手,比如 Siri、Alexa 和 Google Assistant。它们代表用户工作时就是智能体:接收请求、分析上下文、检索信息,然后回答或发起提醒、发送消息、控制智能设备等操作[1]。
- 客服聊天机器人,可以回答问题、引导排查故障、在内部数据库里提交工单,或者完成交易[1]。
- 电子游戏里由大语言模型驱动的非玩家角色(NPC)。它们能根据上下文回应,适应玩家的互动,而不是死板地执行行为树[1]。
一句话总结
智能体以大语言模型作为推理核心,能理解自然语言,进行推理和规划,并通过收集信息、采取行动、观察结果,与环境互动[1]。
下一步
先搞清楚大脑和工具的分工,再去看工具的设计。实际动手时,可以先用 ReAct 的思路写一个只有两三个工具的小智能体,观察每一轮的思考和行动是否符合预期。
本文改编自 Hugging Face 开源课程《Agents Course》第 1 单元[1][2],原文以 Apache-2.0 许可证发布。
来源
- 1What is an Agent?Hugging Face agents-course (Apache-2.0)
- 2Thought: Internal Reasoning and the ReAct ApproachHugging Face agents-course (Apache-2.0)
引用本页: 智能体是什么:思考、行动、观察循环. TellWorld, https://www.tellworld.net/zh/practice/practice-agent-what-are-agents. 更新于 2026-11-14